Bir ajan görevi bir kez başardıysa ikinci kez de başaracak mı?
IBM araştırmacıları, ajan değerlendirmelerinde tek seferlik başarının yanıltıcı olduğunu ve tutarlılığın ayrıca ölçülmesi gerektiğini savunuyor.
Ajan provada çalışıyor, canlı demoda farklı bir yol izleyip aynı görevde başarısız oluyor. Sahnede utanç verici; üretimde ise güvenilirlik sorunu. Bir kullanıcı aynı isteği ikinci kez yaptığında bir kez başarılı olmuş akış bu sefer çökebiliyor. Finansal bir işlemi mutabakata bağlamak ya da bir sözleşmeyi yükümlülük açısından denetlemek gibi kritik işlerde bu, doğrudan engelleyici bir durum.
IBM araştırmacılarının yazısı, kıyaslama tablolarının bu değişkenliği ortalamanın arkasına sakladığını savunuyor ve somut bir örnek veriyor. AppWorld testinde GPT-4.1 kullanan bir ReAct ajanı, beş tekrarda ortalama yüzde 77,4 başarı gösteriyor. Ancak görevlerin yalnızca yüzde 53,0'ünde beş çalıştırmanın hepsinde başarılı oluyor. Aradaki 24,4 puanlık fark, yazının "tutarlılık açığı" adını verdiği şey — zor görevlerde bu fark 30 puana çıkıyor.
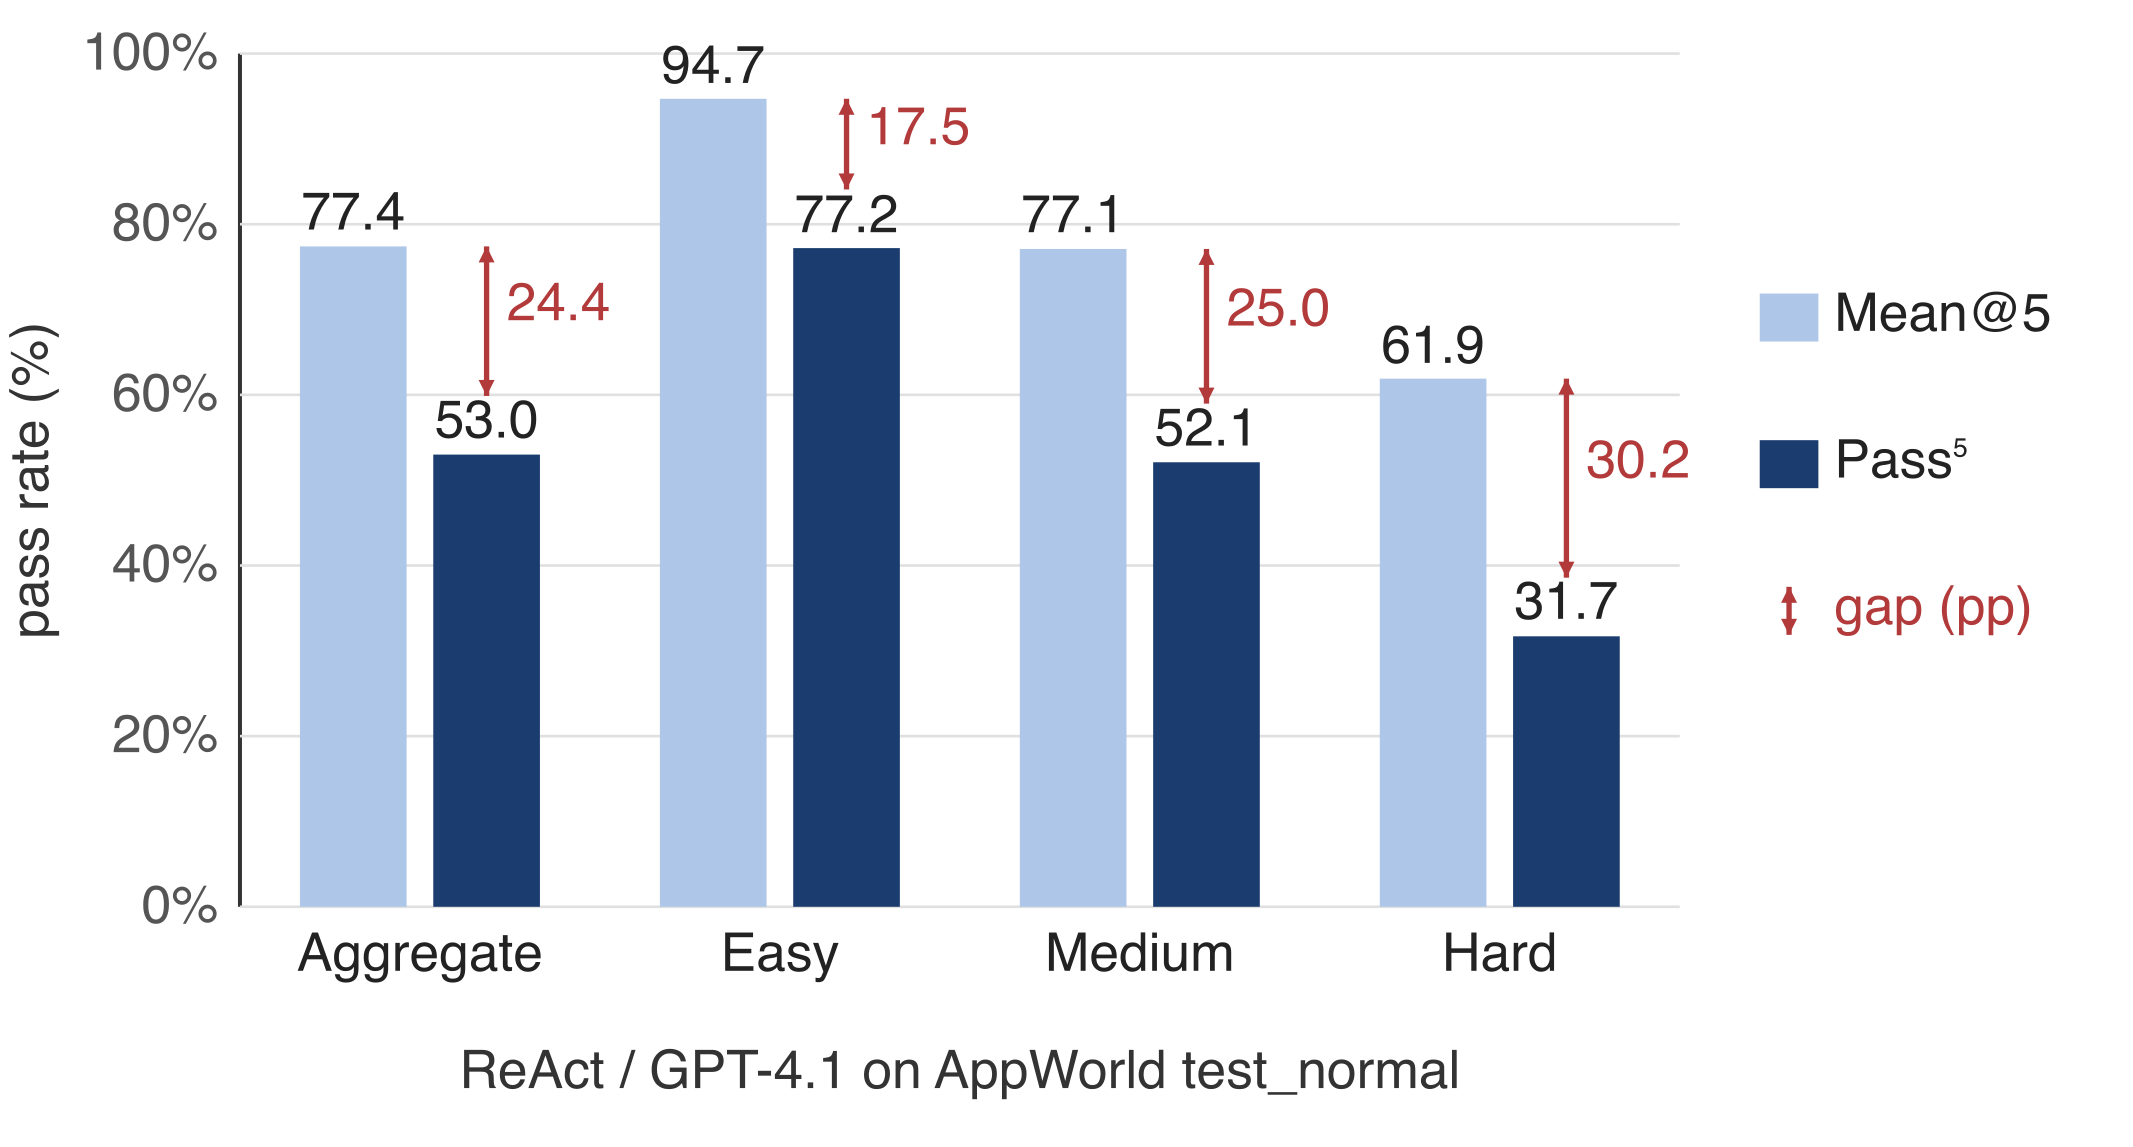
Ayrımı anlamak için iki ölçüyü birbirinden ayırmak gerekiyor. Standart değerlendirme ortalama başarı oranını veriyor: kıyaslamayı birkaç kez çalıştır, geçme oranını ortala. Sıralamalardaki "yüzde 77 başarılı" ifadesi bunu anlatıyor. Buna karşılık her denemenin başarılı olmasını şart koşan ölçü, ajanın tüm çalıştırmalarda başarılı olduğu görevlerin oranını veriyor. Yazının altını çizdiği bir karışıklık da var: bu ölçü, "k denemeden en az biri başarılı oldu mu?" sorusunu soran iyimser ölçüyle karıştırılmamalı — ikincisi doğrulama ve yeniden deneme imkânı olduğunda doğru soru, birincisi ise onun karamsar aynası.
Yazarların vurgusu şu: bu, daha büyük bir modelle çözülecek bir yetenek sorunu değil. Tutarlılık ayrı bir eksen; bir ajan aynı anda hem yetenekli hem tutarsız olabiliyor. Kıyaslamanın neredeyse dörtte biri, görevde hiçbir şey değişmediği hâlde ajanın bazen çözüp bazen çözemediği işlerden oluşuyor.
Ekip bunun için Consistency Analyzer adlı bir tanı aracı geliştirmiş. Araç, ajanın kendi kayıtlı yörüngesini yeniden örnekleyerek "dönmeye yatkın" karar noktalarını buluyor — modelin tek bir jeton örneklemesi farkla başka bir şey yapabileceği adımları. Yöntemin pratik avantajı maliyet: tek bir kayıt yetiyor, gerçek cevaba ihtiyaç duymuyor ve görevi baştan sona yeniden çalıştırmak yerine her karar noktasını tek çağrıda birkaç tamamlama isteyerek yeniden örnekliyor.
Tanının kılavuza dönüştürülmesiyle elde edilen sonuç da paylaşılıyor: tutarlılık açığı 24,4 puandan 12,0 puana iniyor, yani yarıya düşüyor — üstelik ortalama doğrulukta herhangi bir kayıp olmadan. Yöntem, ajanın geçmiş yörüngelerini otomatik olarak yeniden kullanılabilir kılavuzlara dönüştüren ALTK-Evolve sisteminin üzerine kuruluyor.
Comments (0)
No comments yet.
Comments are moderated before publishing.