Yapay Zeka Modellerinde 20 Kat Hız Artışı: Amazon ve Booking.com'dan Yeni Optimizasyon
Amazon ve Booking.com, Bilgi Damıtma ve Medusa tekniklerini birleştirerek 1,1 milyar parametreli modelleri 70 milyar parametreli dev modellerin performansına ulaştırdı.
Amazon Science ve Booking.com araştırmacıları, büyük dil modellerinin (LLM) çalışma hızını artırırken işlem maliyetlerini düşüren iki aşamalı bir optimizasyon mimarisi geliştirdi. Bilgi Damıtma (Knowledge Distillation) yöntemi ile Medusa-2 mimarisini bir araya getiren çalışma kapsamında, 1,1 milyar parametreli TinyLlama modeli, 70 milyar parametreli Llama-3.1 modelinin yanıt kalitesine ulaştırıldı. Elde edilen kompakt model, dev öğretmen modeline kıyasla 10 ila 20 kat daha hızlı çalışırken işlem maliyetini üçte birden fazla oranında düşürdü.
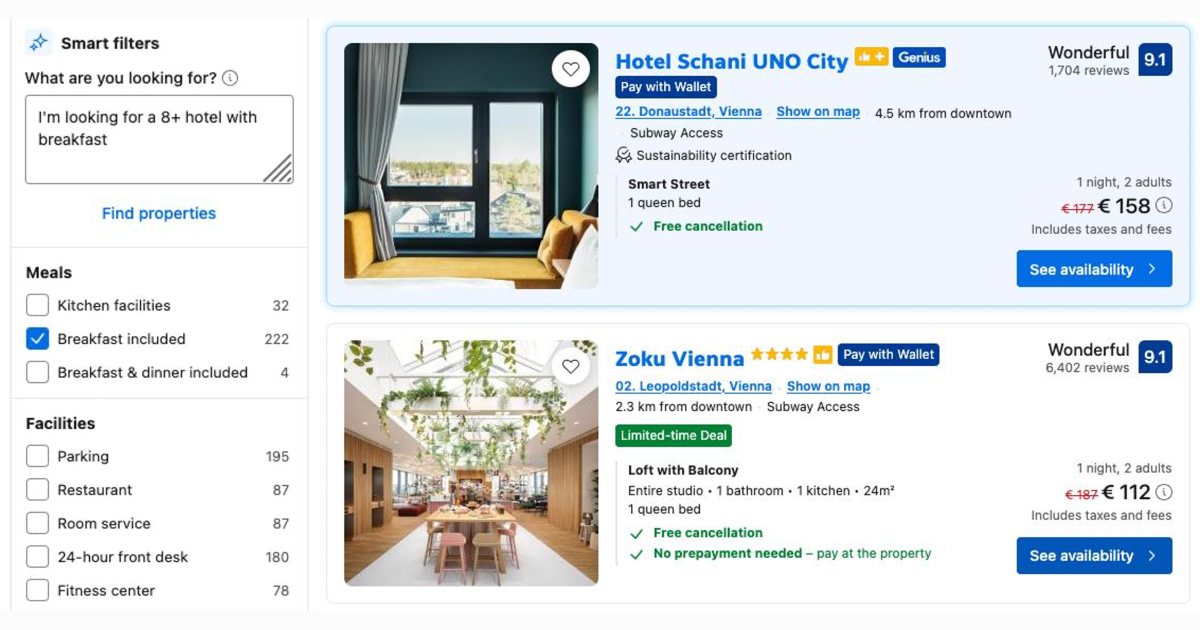
Geliştirilen sistem, Booking.com platformundaki üç farklı canlı senaryoda test edildi. Doğal dildeki aramaları anlık verilere dönüştüren Akıllı Filtreler özelliğinde, sorguların yüzde 99'unda 15 kat daha hızlı yanıt alındı. Yalnızca Bilgi Damıtma yöntemi uygulandığında, öğrenci ve öğretmen model arasındaki kalite farkı yüzde 90'dan fazla kapandı ve çıkarım hızı 6 kat arttı. Bu yapıya entegre edilen Medusa modülleri ise paralel jeton (token) tahminiyle hıza 2 ila 3,6 kat ek performans sağladı.
Kullanıcı etkileşimi ve yanıt kalitesi arttı
Görüşme tabanlı Yapay Zeka Gezi Planlayıcısı uygulamasında yeni mimari, GPT-3.5 modeline kıyasla kullanıcı etkileşimini yüzde 2,9 artırdı. Milyonlarca tesis için otomatik metin oluşturan Konaklama Tanımı Oluşturucu servisinde ise metinlerin kullanıcılar tarafından "faydalı" olarak işaretlenme oranı yüzde 1,4 yükseldi. Bilgisayarlı Dilbilim Derneği (ACL) konferansında endüstri kategorisinde en iyi bildiri ödülünü kazanan teknik, büyük modellerin sunduğu kaliteyi küçük modellerin hız avantajıyla birleştiriyor.
Büyük dil modellerinin yüksek parametre sayıları, mobil ve web uygulamalarında yüzlerce milisaniyelik gecikmelere yol açarak kullanıcı deneyimini olumsuz etkileyebiliyor. Sunucu tarafındaki GPU maliyetlerini de artıran bu tablo karşısında, küçük modellerin paralel veri işleme teknikleriyle desteklenmesi, yüksek trafikli platformlar için ölçeklenebilir bir alternatif oluşturuyor.
Comments (0)
No comments yet.
Comments are moderated before publishing.