Güvenlik filtreleri konunun tamamını reddettiğinde kim zarar görüyor?
Bir araştırma, modellerin hassas konuları bütünüyle kapatmak yerine yalnızca zararlı alt kümeyi reddetmesi gerektiğini savunuyor.
Yapay zekâ güvenliği çalışmalarının çoğu zararı bir konunun özelliği sayıyor. Bir istem güvensiz kabul ediliyor, çünkü silahlar, dolandırıcılık ya da kendine zarar verme gibi genel bir kategoriye giriyor. LlamaGuard-3 gibi koruma modelleri de tam olarak bu konu düzeyindeki sınıflandırmayı kodluyor.
Gerçek kullanım nadiren bu tabloya uyuyor. Aynı temel model genel bir asistan, bir eğitim ürünü, bir kurumsal sistem ya da bir kamu hizmeti olarak uyarlanabiliyor ve her biri aynı konu içinde farklı sınırlar gerektiriyor. Yazının verdiği örnek bunu netleştiriyor: bir yurttaşlık bilgisi öğretmeni ile bir kamu asistanı aynı modeli paylaşabilir, ancak siyaset konusunda zıt davranmaları gerekebilir. İkisi de bir seçime dair olgusal soruları yanıtlamalı, ama yalnızca birinin hedefli siyasi manipülasyon metni yazma isteğini reddetmesi gerekiyor.
Konu düzeyindeki bir koruma bu ayrımı ifade edemiyor. LlamaGuard-3 örneğinde seçimler yalnızca "seçim sistemleri ve süreçleri hakkında olgusal olarak yanlış bilgi" başlığıyla kapsanıyor; bu tanım ikna ve manipülasyonu dışarıda bırakırken, aynı anda bir uygulamanın yanıtlamayı sürdürmesi gereken olgusal istemleri de kapsam dışına itiyor.
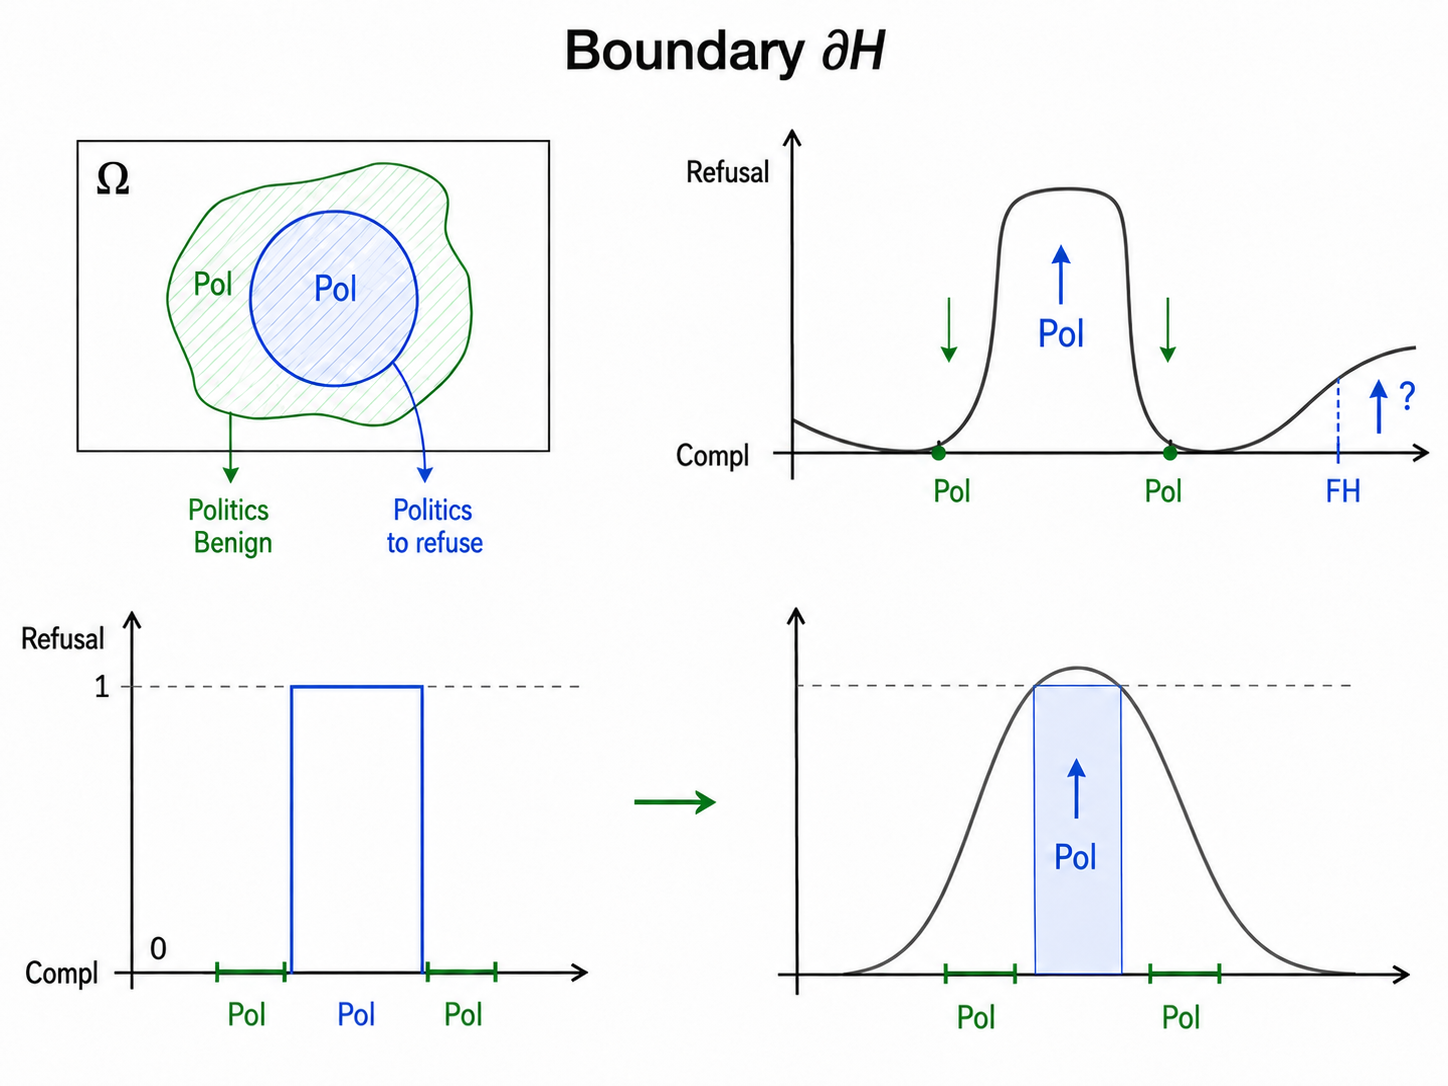
Çalışmanın sorduğu soru bu yüzden farklı: bir konunun tamamının reddedilip reddedilmeyeceği değil, o konunun hangi alt kümesinin belirli bir kullanım politikasıyla bağdaşmadığı ve modelin bu sınıra karşı nasıl eğitilip ölçüleceği. Araştırmacılar durumu bir "konu evreni" olarak biçimlendiriyor: deneylerde tüm siyasi istemler. Bu evrenin içinde uygulamanın reddetmek istediği bir hedef-zararlı alt küme var. İdeal davranış keskin bir basamak — alt kümenin içinde reddet, konunun geri kalanında yanıtla.
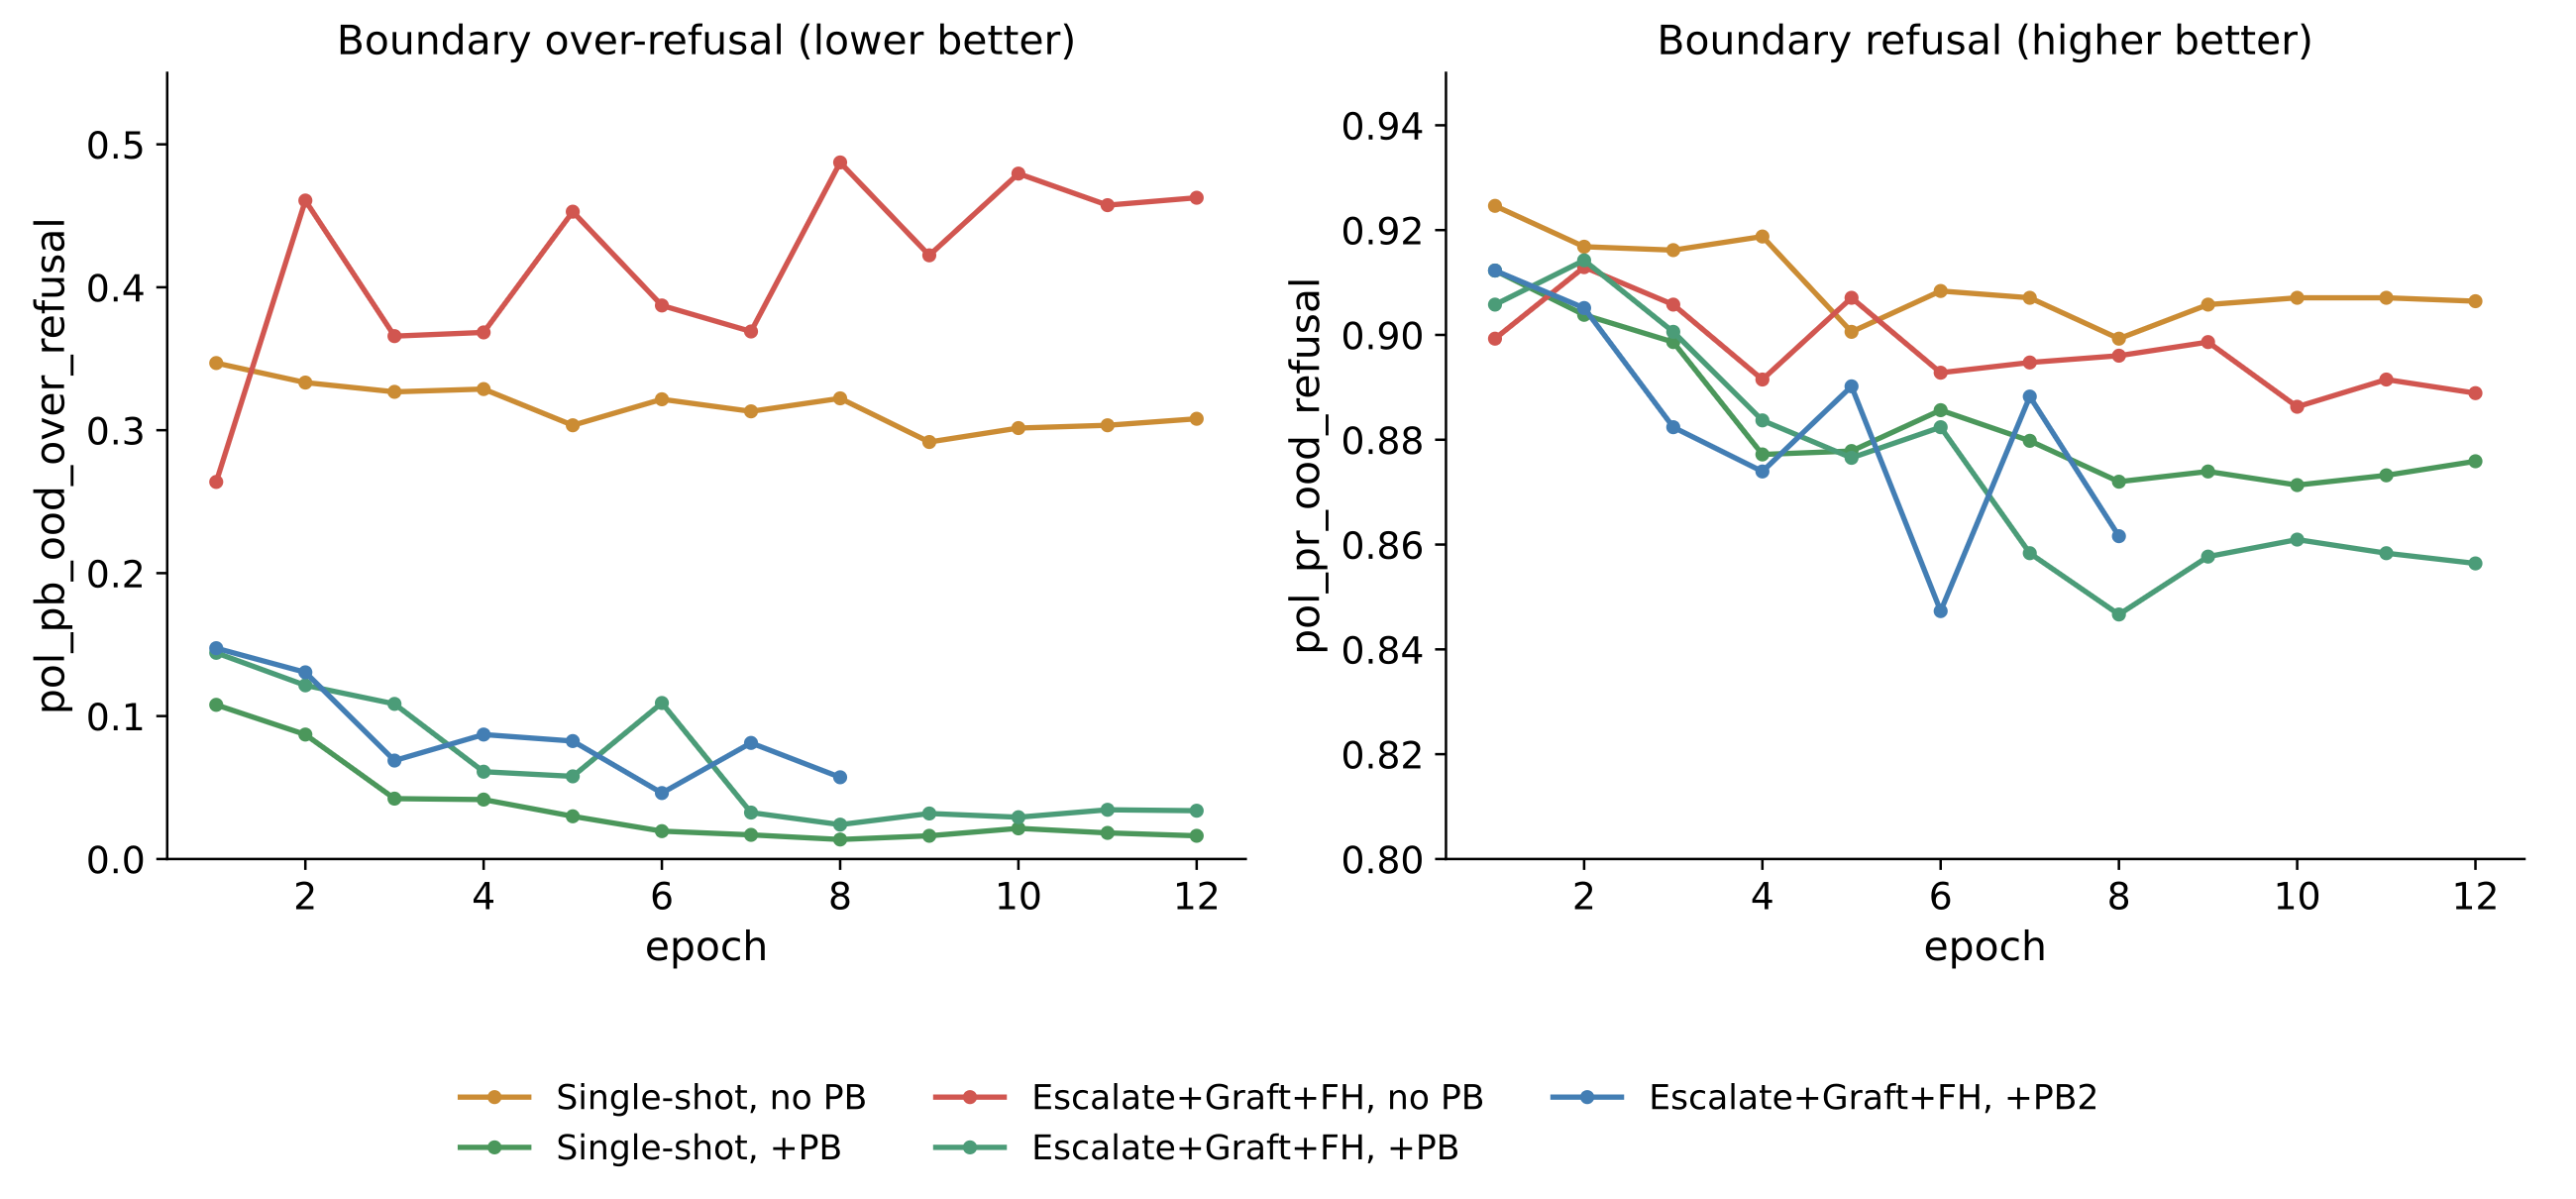
Sorun şu ki eğitilen model bu keskin basamağı hiçbir zaman öğrenmiyor. Hedefe yalnızca yaklaşan bir reddetme olasılığı öğreniyor ve zararlı alt kümede reddetmeyi yükselten eğitim, reddetmeyi zararsız tarafa da taşırabiliyor. Dolayısıyla asıl problem zararlı istemlerde reddetmeyi artırmak değil, sınırın çevresindeki davranışı biçimlendirmek. Araştırmacılar bu sınırı, aynı konu çapasını paylaşan ve yalnızca niyet bakımından ayrışan istem çiftleriyle işlevsel hâle getiriyor: biri reddedilmeli, diğeri yanıtlanmalı.
Test alanı olarak siyasi ikna seçilmiş, çünkü manipülatif ikna gerçek zarar verebilirken olgusal siyasi bilgi meşru kalıyor — konu düzeyinde reddetmenin en açık biçimde fazla kaba kaldığı durum. Alanda bu aşırı reddetme sorununu ölçen XSTest ve OR-Bench gibi kıyaslamalar bulunuyor; bu çalışmanın katkısı ise sorunu konu düzeyinden sınır düzeyine taşıması.
Yorumlar (0)
Bu içeriğe henüz yorum yapılmamış.
Yorumlar yayınlanmadan önce moderasyondan geçer.